НАЦIОНАЛЬНИЙ ТЕХНIЧНИЙ УНIВЕРСИТЕТ УКРАЇНИ
«КИЇВСЬКИЙ ПОЛIТЕХНIЧНИЙ IНСТИТУТ імені IГОРЯ СIКОРСЬКОГО» Теплоенергетичний факультет
Кафедра автоматизації проектування енергетичних процесів i систем
КУРСОВА РОБОТА
з дисципліни ”Основи розробки трансляторів” на тему:
Розробка та імплементація мови програмування ApeLang
Студента 3 курсу групи ТI-81 спеціальності 121 ”Інженерія програмного забезпечення”
Андрєєва Данила Максимовича
Керівник к.т.н. доц. Стативка Ю.I.
Кількість балів: ______ Оцінка: _________
Члени комісії: к.т.н., доц. Стативка Ю.І.
(підпис) (вчене звання, науковий ступінь, прізвище та ініціали)
ас. Воронько М.П.
(підпис) (вчене звання, науковий ступінь, прізвище та ініціали)
(підпис) (вчене звання, науковий ступінь, прізвище та ініціали)
Київ – 2021
АНОТАЦIЯ
Метою курсової роботи є розробка імперативної мови загального призначення та її імплементація засобами мови програмування C++.
Розроблена імперативна мова загального призначення може використовуватись для базових задач програмування та використання таких засобів програмування, як: арифметичні операції, введення-виведення даних, оператор циклу та оператор розгалуження.
Програмний застосунок містить в собі лексичний аналізатор розробленої мови з використанням таблиці лексем мови, синтаксичний аналізатор, транслятор та інтерпретатор коду.
Ключові слова: формальна граматика, специфікація мови програмування, лексичний аналіз, таблиця символів, діаграма станів, синтаксичний аналіз, трансляція, постфіксна нотація.
ЗМIСТ
ВСТУП 5
Висновок 17
2. АРХІТЕКТУРА, МЕТОДИ ТА АЛГОРИТМИ 18
Висновок 20
3.1 Опис програмної реалізації лексичного аналізатора 21
3.2 Опис програмної реалізації транслятора 22
3.3 Опис програмної реалізації інтерпретатора 24
Висновок 25
Висновок 35
ВИСНОВКИ 36
ДОДАТКИ 38
1. Граматика мови 38
2. Таблиця лексем 40
ВСТУП
Мова програмування - це інтерфейс, за допомогою якого програміст може створювати алгоритми та транслювати ці алгоритми в код, зрозумілий процессору. З роками мови програмування поліпшилися. Таким чином, було розроблено assembler, що допомагав легче створювати програми. З часом з’явилися мови програмування високого рівня, такі як C, C++ з ООП. Надалі еволюцією мов програмування стали скриптові мови. Більшість з них підтримує динамічну типізацію и полегшує роботу, але за це приходиться платити часом виконання.
Завдання цієї роботи - розробити транслятор і інтерпретатор для заданої граматики мови. Також розробити інтерфейс користувача і протестувати мову.
Цільова мова надає користувачу механізми для виконання базових операцій, таких як: створення змінних, присвоєння значень, операції порівняння, операції множення, додавання, віднімання і ділення. Також мова надає доступ до операторів розгалуження, циклу, виведення до консолі.
Алгоритм трансляції:
Після трансляції, код віртуальної машини можна виконати за допомогою ARE (Ape Runtime Environment).
1. СПЕЦИФIКАЦIЯ МОВИ
1.1 Індивідуальне завдання
Арифметика: цілі та дійсні числа, основні чотири арифметичні операції (додавання, віднімання, ділення та множення), піднесення до степеня (правоасоціативна операція), дужки.
Особливості: експоненційна форма дійсного числа
Інструкція повторення: for (<ід>=<вираз>; <відношення>; <ід>=<вираз>){<cписок операторів>}
Інструкція розгалуження: if <відношення> {<список операторів>}
1.2 Опис мови
Цільова мова підтримує змінні трьох типів: int, float та bool. Цілі та дійсні числа можуть мати від’ємне значення.
Тип змінної вказується при ініціалізації. Під час ініціалізації змінній можна присвоїти значення. Синтаксис мови С-подібний.
1.3 Синтаксис
Літерали
Синтаксис
IntConst = [Sign] UnsignedInt
FloatConst = [Sign] UnsignedFloat | UnsignedDoubleExpForm
Sign = ‘+’ | ’-’
UnsignedInt = Digit {Digit}
UnsignedDoubleExpForm = UnsignedDouble ’e’ [Sign] IntNumb
UnsignedReal = UnsignedInt ’.’ UnsignedInt
BoolConst = true | false
Обмеження
Семантика
Приклади
Інструкції
Синтаксис
StatementList = Statement { Statement }
Statement = (Assign | Inp | Out | Declaration) ‘;’ | ForStatement
| IfStatemant
Опис
Обмеження
Семантика
Приклад
int a = 10;
a = 12;
int b = 1;
b = 2;
float c = 10.2;
c = c + 12.2;
}
Вирази
Синтаксис
BoolTerm = BoolFactor | BoolTerm ‘&&’ BoolFactor
BoolFactor = BoolRelation | ‘(‘ BoolTerm ‘)’
BoolRelation = Expression [RelOp Expression]
Expression = Term | Expression AddOp Term
Term = Factor | Term MultOp Factor
Factor = FirstExpr | Factor PowOp FirstExpr
FirstExpr = ‘(’ Expression ‘)’ | Ident | Const
Опис
Обмеження
Семантика
Приклади
11, x, (a + 2 * 4)
b == 2, 2 < 100 || a <= 2, (x * x + a / b) >= l
Оголошення змінної
Синтаксис
IdentDecl = Ident [‘=’ Expression]
Type = int | float | bool
Опис
Обмеження
Семантика
Приклад
float c;
bool r;
Інструкція присвоєння
Синтаксис
Опис
Обмеження
Семантика
Приклад
Оператор розгалуження
Синтаксис
if <відношення> then <оператор> else<оператор>
DoBlock1 = DoBlock
DoBlock2 = DoBlock
DoBlock = ’{’ StatementList ’}’
Опис
Семантика
Приклад
if (num == 1) {
num = num + 1;
} else {
num = num – 1;
}
Оператор циклу
Синтаксис
IndExpr = Type Ident ’=’ BoolExpression
ArithmExpression1 = BoolExpr
ArithmExpression2 = BoolExpr
DoBlock = ’{’ StatementList ’}’
Опис
Обмеження
Семантика
ArithmExpression1.
Приклад
print(i);
}
Оператор введення
Синтаксис
Опис
Приклад
Оператор виведення
Синтаксис
Опис
Обмеження
Приклад
1.4 Формат таблиць
Таблиця символiв програми (таблиця розбору)
Розбір реалізовано за допомогою методу nextToken классу Lexer. Метод повертає екземпляр классу Token, який містить в собі наступну інформацію:
Лексеми бувають наступних типів:
При розборі літералів, операторів, ключових слів і констант використовуються класси, що розширюють Token. Наприклад, NumberToken, OperatorToken, KeywordToken.
Висновок
В наведеному вище розділі було представлено специфікацію мови програмування ApeLang, яка дає змогу зрозуміти особливості написання коду і використання операцій цієї мови. Було наведено структуру, сементику, обмеження , синтаксис і список операторів.
2. АРХIТЕКТУРА, МЕТОДИ ТА АЛГОРИТМИ
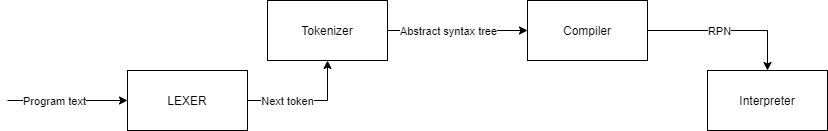
Архітектура розробленого компілятора складається з лексичного аналізатора, що розбирає вхідний текст на набір лексем. Далі, семантичний аналізатор створює абстрактне синтаксичне дерево за допомогою методу рекурсивного спуску. Суть методу в аналізі токенів за допомогою рекурсивного викликуу або циклічно рекурсивного виклику методів аналізу різних синтаксичний структур мови. Це дерево перевіряється на логічні помилки і передається в транслятор, який перетвор.є абстрактне синтаксичне дерево у набір інструкцій у ПОЛІЗ-подібному вигляді інструкцій для віртуальної машини.
Рис. Архітектура системи.
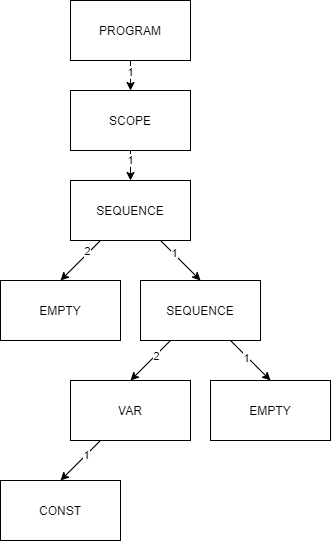
Рис. Абстрактне синтаксичне дерево.
Для оптимізації роботи з пам'яттю лексичний аналізатор являється модулем, реалізуючим метод nextToken(). Таким чином, він не генерує массив токенів а завжди повертає наступний. Цей підхід використовується у класі Tokenizer.
Після трансляції у набір ПОЛІЗ-подібних команд вони виконуються в віртуальній машині(інтерпретаторі). Команди для віртуальної машини представляють собою команди низького рівня, серед яких елементарні арифметичні операції між двома значеннями на вершині стеку, запис значень до стеку, видалення значень зі стеку, директива переходу(jump) та її розширення.
Висновок
В розділі архітектура, методи та алгоритми представлено основні схеми та етапи розробки програми, наведено опис використаних методів, таких як метод рекурсивного спуску, трансляція та інтерпретація виразів у ПОЛІЗ. Також представлено алгоритм роботи лексичного аналізатора.
3. ПРОГРАМНА РЕАЛIЗАЦIЯ
3.1 Опис програмної реалізації лексичного аналізатора
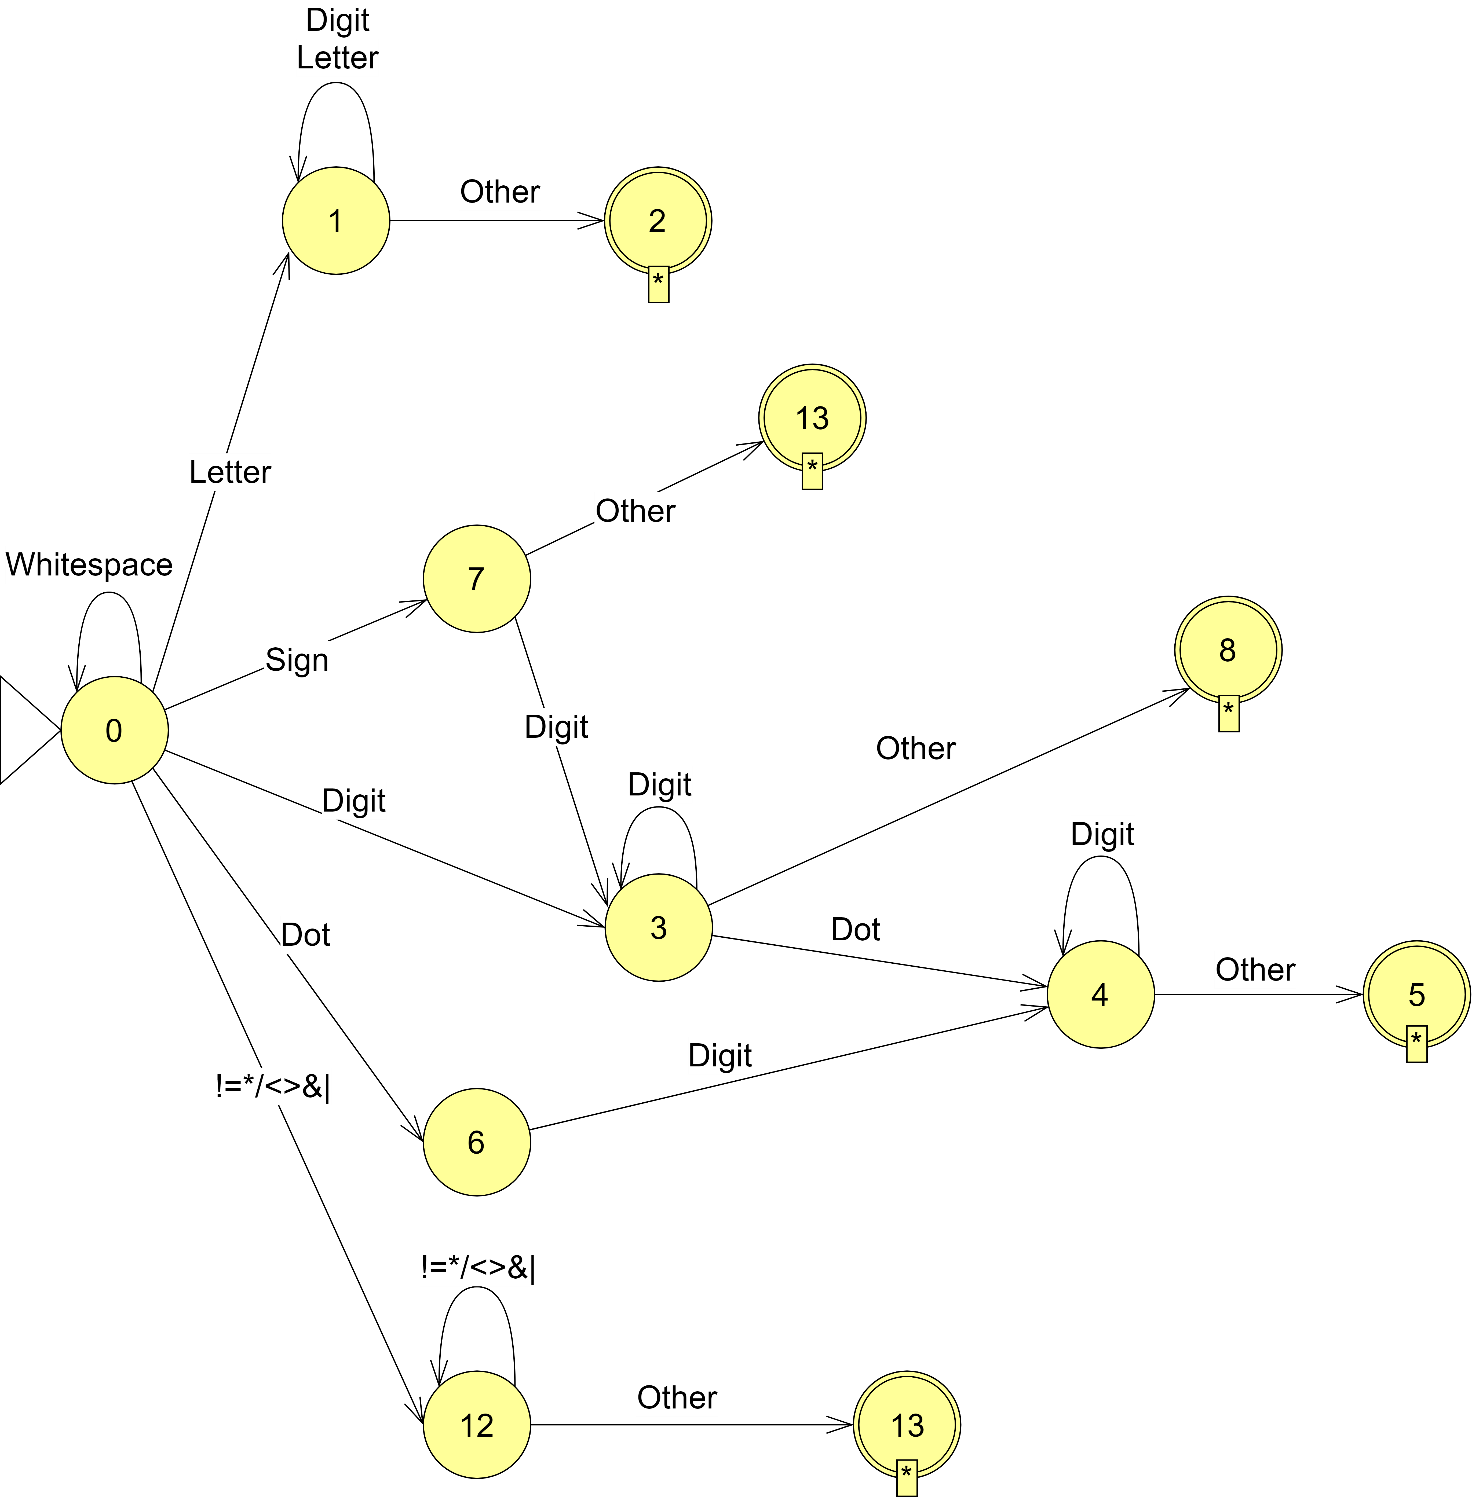
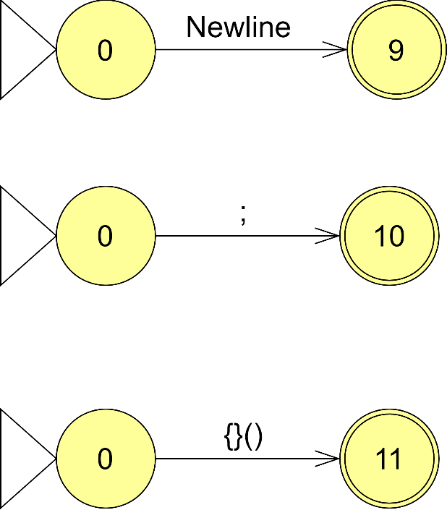
Лексичний аналізатор працює за допомогою таблиці допустимих лексем, а саме:
Таким чином, лексичний аналізатор переміщується по тексту програми вперед і коли знаходить символ, що не потрібно ігнорувати - починає інтерпретувати наступні символи за пріоритетом:
Метод Lexer::nextToken() з кожним викликом зміщується по тексту програми у напрямку від початку до кінця тексту і повертає наступну знайдену лексему.
Для перевірки закінчення розбору тексту використовується метод Lexer::isEof().
Для розбору лексем на позиції курсора в тексті використовуються методи:
Якщо лексичний аналізатор знайшов заборонений символ - буде створено екземпляр виключної ситуації ApeLangException.
3.2 Опис програмної реалізації транслятора
Трансляція виконується в три етапи:
Для створення абстрактного синтаксичного дерева використовується метод Tokenizer::parse(). Створення абстрактного синтаксичного дерева виконується за допомогою методу рекурсивного спуску. Реалізують цей механізм наступні методи классу:
Під час створення абстрактного синтаксичного дерева перевіряються синтаксичні помилки, такі як неправильний порядок слідування токенів.
Базовим классом вузла дерева є класс Node. Його розширюють:
Кожен вузол має три посилання на операнди від 1 до 3. За замовчуванням всі посилання дорівнюють nullptr.
Рис. Схема абстрактного синтаксичного дерева.
Після створення абстрактного синтаксичного дерева виконується перевірка останнього на логічні помилки, такі як:
Перевірка здійснюється за допомогою метода Tokenizer::validateTree(). Метод перевіряє типи даних і області видимості.
Після перевірки абстрактного синтаксичного дерева метод Compiler::compile() транслює інформацію з абстрактного синтаксичного дерева у набір команд для інтерпретатора.
3.3 Опис програмної реалізації інтерпретатора
Для демонстрації незалежності інтерпретатора від транслятора інтерпретатор було реалізовано за допомогою мови python. Інтерпретатор реалізовано у вигляді стекової віртуальної машини для наглядності.
Інтерпретатор йде послідовно по командах і виконує задані операції. Інтерпретатор розуміє наступні команди:
Команди виконуються за правилами обробки виразів в ПОЛІЗ.
Висновок
У наведеному розділі показана програмна реалізація ключових механізмів компілятора. Трансляція виконується за допомогою побудови абстрактного синтаксичного дерева. Інтерпретація виконується за допомогою стеку.
4. ТЕСТУВАННЯ
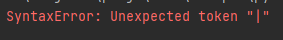
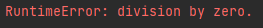
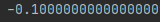
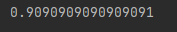
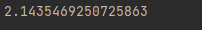
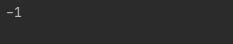
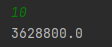
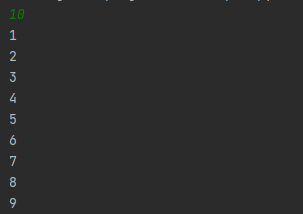
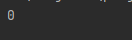
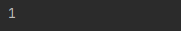
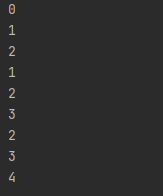
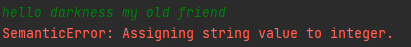
В таблицях 1 і 2 наведено протокол тестування та результат виконання програми. Протестовано основні помилки, які можливо допустити при написанні програми, як лексичні, синтаксичні, так і логічні. Також наведено результати виконання арифметичних дій, операторів циклу та розгалуження. Наявні приклади введення числа з консолі та виведення змінних.
Таблиця 1 – Протокол тестування
Номер тесту | Зміст тесту | Результат |
1 | Пропуск дужки ‘{’ на початку програми. | Помилка про відсутність дужки, локалiзацiя, дiагностичне повiдомлення |
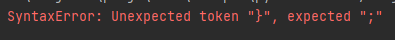
2 | Пропуск ‘;’ в кінці рядка | Помилка про відсутність ‘;’, локалiзацiя, дiагностичне повiдомлення |
3 | Відсутність даних після операції присвоєння | Помилка про очікування виразу, оператору порівняння чи ідентифікатора, локалiзацiя, дiагностичне повiдомлення |
4 | Пропуск дужки ‘(‘ в арифметичному виразі | Помилка про відсутність ‘(’, локалiзацiя, дiагностичне повiдомлення |
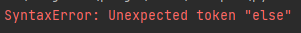
5 | Пропуск дужки ‘(‘ в умовному операторі | Помилка про відсутність ‘(’, локалiзацiя, дiагностичне повiдомлення |
6 | Пропуск дужки ‘{‘ в умовному операторі | Помилка про відсутність ‘{’, локалiзацiя, дiагностичне повiдомлення |
7 | Пропуск символу ‘}‘ в умовному операторі | Помилка про відсутність символу ‘}’, локалiзацiя, дiагностичне повiдомлення |
8 | Пропуск одного символу ‘&’ при операції ‘і’ | Помилка в лексичному аналізаторі про відсутність лексеми |
9 | Відсутність ідентифікатору або виразу після операції степінь чи експонента | Помилка про очікування виразу, оператору порівняння чи ідентифікатора, локалiзацiя, дiагностичне повiдомлення |
10 | Відсутність ідентифікатору або виразу після операції порівняння | Помилка про очікування виразу, оператору порівняння чи ідентифікатора, локалiзацiя, дiагностичне повiдомлення |
11 | Відсутність символа ‘{’ в операторі порівняння | Помилка про відсутність ‘{’, локалiзацiя, дiагностичне повiдомлення |
12 | Ділення на нуль | Помилка і повідомлення про ділення на нуль |
13 | Додавання | Результат додавання |
14 | Віднімання | Результат віднімання |
15 | Множення | Результат множення |
16 | Ділення | Результат ділення |
17 | Піднесення до степеня | Результат піднесення до |
степеня | ||
18 | Експоненціальна форма дійсного числа | Результат присвоєння змінній константи в експоненціальній формі. |
19 | Від’ємне число | Результат присвоювання змінній від’ємного числа |
20 | Факторіал додатного числа | Підрахунок факторіалу |
21 | Факторіал від’ємного числа | Результат - 0 |
22 | Виведення введеної кількості чисел через оператор циклу | Введена кількість чисел в таблиці виведення |
23 | Умовний оператор з умовою, яка виконується | Виконання операції умовного оператора якщо умова виконується |
24 | Умовний оператор з умовою, що не виконується | Виконання операції умовного оператора якщо умова не виконується |
25 | Вкладений умовний оператор в інший умовний оператор | Виконання програми |
26 | Вкладений оператор циклу в інший оператор циклу | Виконання програми (наприклад, робота з елементами масиву) |
27 | Вкладений оператор циклу в умовний оператор | Виконання програми |
28 | Введення списку даних | Запит на введення даних та присвоєння цих даних змінним |
29 | Виведення списку даних | Виведення кожного елементу зі списку |
30 | Введення некоректних даних через консоль | Виведення помилки в консоль |
31 | Введення числа з плаваючою точкою до змінної яка має тип цілого числа | Присвоєння змінній значення приведеного з дійсного типу до цілого |
32 | Введення цілого числа до змінної яка має тип дійсного числа | Присвоєння змінній значення приведеного з цілого типу до дійсного |
Таблиця 2 – Результат тестування
Номер тесту | Код програми | Результат |
1 |
| |
2 | { | |
3 | { | |
4 | { | |
5 | bool a = (1 < 0 && (0 || 1); | |
6 | { int a = 0; | |
7 | { } |
8 | bool a = 1 | 2; | |
9 | int a = 2^; | |
10 | bool a = 1 > || 0; | |
11 | for(int i = 0; i < 10; i = i + 1) print(i) | |
12 | int a = 1 / 0; print(a); | |
13 | float a = 1 + 1.1; | |
14 | float = 1 - 1.1; print(a); | |
15 | float a = 2 * 1.1; print(a); | |
16 | float a = 1 / 1.1; print(a); | |
17 | float a = 2 ^ 1.1; print(a); | |
18 | float a = 12e+2; print(a); | |
19 | int a = -1; |
20 | float input = read(); float result; } else { | |
21 | float input = read(); float result; } else { | |
22 | int input = read(); } | |
23 | int a = 2; } else { } | |
24 | int a = 100; } else { } |
25 | int a = 5; } print(0); } | |
26 | int j; } | |
27 | Див. приклад 20 | |
28 | int a = read(); float b = read(); print(a); print(b); | |
29 | int a = 1; float b = 2.0; print(a); | |
30 | int a; | |
31 | int a; | |
32 | float a; |
Висновок
Наведено основні помилки, які можуть виникнути при написанні та інтерпретації коду програми розробленою мовою. Показано результат обробки помилок. Також наведено приклади для арифметичних виразів, оператору циклу, оператору розгалуження, інструкцій введення та виведення та різні випадки роботи з ними. Всі тести пройшли успішно.
ВИСНОВКИ
В наведеній роботі було створено опис і специфікацію мови програмування ApeLang, створено програмну реалізацію наступних модулів:
Після створення програмної реалізації біло наведено стратегію тестування і самі тести.
В наведеній мові було реалізовано базові операції, такі як: додавання, віднімання, множення, ділення, степінь, робота з потоками вводу.
Також було створено систему інформування користувача про помилку та її семантику.
Трансляція відбувається у ПОЛІз-подібні інструкції для віртуальної машини Ape. Це забезпечує кросплатформеність мови і надає змогу програмісту не перейматись за розмірність змінних на операційних системах різної архітектури.
СПИСОК ВИКОРИСТАНИХ ДЖЕРЕЛ
Медведєва, В. А. Третяк. – К. : НТУУ "КПІ", 2012. – 148 с.
посіб. / В. М. Медведєва, В. А. Третяк. – К. : Текст, 2015. – 144 с.
ДОДАТКИ
1. Граматика мови
ProgBody = ’{’ StatementList ’}’
IfStatement = if ‘(‘ BoolExpr ‘)’ DoBlock1 [else DoBlock2]
DoBlock1 = DoBlock
DoBlock2 = DoBlock
ForStatement = for ‘(’ IndExpr ‘;’ BoolExpr ‘;’ IndExpr ‘)’ DoBlock
IndExpr = Type Ident ’=’ BoolExpression
ArithmExpression1 = BoolExpr
ArithmExpression2 = BoolExpr
DoBlock = ’{’ StatementList ’}’
DoSection = ’{’ StatementList ’}’
StatementList = Statement { Statement }
Statement = (Assign | Inp | Out | Initialization) ‘;’ | ForStatement
| IfStatemant
Assign = Ident ’=’ Expression
Inp = read ’(’ Ident ’)’
Out = print ’(’ Ident ’)’
Initialization = Type IdentDecl
IdentDecl = Ident [‘=’ Expression]
Type = int | float | bool
BoolExpr = BoolTerm | BoolExpr ‘||’ BoolTerm
BoolTerm = BoolFactor | BoolTerm ‘&&’ BoolFactor
BoolFactor = BoolRelation | ‘(‘ BoolTerm ‘)’
BoolRelation = Expression [RelOp Expression]
Expression = Term | Expression AddOp Term
Term = Factor | Term MultOp Factor
Factor = FirstExpr | Factor PowOp FirstExpr
FirstExpr = ‘(’ Expression ‘)’ | Ident | Const
Ident = Letter {Letter | Digit}
Const = IntConst | RealConst | BoolConst
IntConst = UnsignedInt
RealConst = UnsignedReal
Sign = ‘+’ | ’-’
UnsignedInt = Digit {Digit}
UnsignedReal = UnsignedInt ’.’ UnsignedInt
BoolConst = true | false
SpecSymbols = ArithOp | BoolOp | RelOp | BracketsOp
| AssignOp | Semicolon
ArithOp = AddOp | MultOp | PowOp
AddOp = ’+’ | ’-’
MultOp = ’*’ | ’/’
PowOp = ‘^’
BoolOp = ‘&&’ || ‘||’
RelOp = ’==’ | ’<= ’ | ’<’ | ’>’ | ’>=’ | ’!=’
BracketsOp = ’(’ | ’)’
BracesOp = ‘{’ | ‘}’
AssignOp = ’=’
Semicolon = ’;’
KeyWords =
| int | float| bool
| read | print
| for | while
| if | else
Letter = ’a’ | ’b’ | ’c’ | ’d’ | ’e’ | ’f’ | ’g’ | ’h’ | ’i’ | ’j’
| ’k’ | ’l’ | ’m’ | ’n’ | ’o’ | ’p’ | ’q’ | ’r’ | ’s’ | ’t’
| ’u’ | ’v’ | ’w’ | ’x’ | ’y’ | ’z’
Digit = ’0’ | ’1’ | ’2’ | ’3’ | ’4’ | ’5’ | ’6’ | ’7’ | ’8’ | ’9’
SpecSsign = ’.’ | ’,’ | ’:’ | ’;’ | ’(’ | ’)’
| ’=’ | ’+’ | ’-’ | ’*’ | ’/’ | ’<’ | ’>’ | ‘!’ | ‘^’
| WhiteSpace | EndOfLine
WhiteSpace = ’ ’ | ’\t’
EndOfLine = ’\n’ | ’\r’ | ’\r\n’ | ’\n\r’
EndOfFile = \0
2. Таблиця лексем
Таблиця 1 – Таблиця лексем
Код | Приклади лексем | Токен | Неформальний опис |
a, x1, z12f | Identifier | ідентифікатор | |
123, 0, 521 | Const | ціле без знаку | |
12.0 | Const | дійсне без знаку | |
true, false | Const | логічне значення | |
int | Keyword | символ integer | |
float | Keyword | символ float | |
bool | Keyword | символ bool | |
read | Keyword | символ read | |
Keyword | символ print | ||
for | Keyword | символ for | |
by | Keyword | символ by | |
while | Keyword | символ while | |
do | Keyword | символ do | |
if | Keyword | символ if | |
then | Keyword | символ then | |
else | Keyword | символ else | |
= | Operator | символ = | |
+ | Operator | символ + | |
- | Operator | символ - | |
* | Operator | символ * | |
/ | Operator | символ / | |
^ | Operator | символ ^ | |
< | Operator | символ < | |
<= | Operator | символ <= | |
== | Operator | символ == | |
>= | Operator | символ >= | |
> | Operator | символ > | |
!= | Operator | символ != | |
&& | Operator | символ && | |
|| | Operator | символ || | |
( | Operator | символ ( | |
) | Operator | символ ) | |
{ | Operator | символ { | |
} | Operator | символ } | |
. | Operator | символ . | |
, | Operator | символ , | |
: | Operator | символ : | |
; | Operator | символ ; | |
\32,\t | Whitespace | пробільні символи | |
\n, \r\n | EOL | кінець рядка | |
\0 | FEOF | кінець файлу |
3. Діаграма станів
Рисунок 1 – Діаграма станів